


发布人 :koya tibb发布时间 :2026-09-04 16:07:10
很多医生第一次接触医疗AI时,都会有一个很自然的问题,机器没有临床经验,它为什么能从冠脉CTA中“学”到有用的信息?答案并不神秘。和医生通过病例积累经验有些相似,算法也需要经历一条完整的学习路径:用数据学习规律,再用未参与训练的数据检验性能。但对医疗AI来说,真正重要的从来不只是“学会了”,而是:面对新的患者、新的病例,它还能不能保持稳定。这也是理解深脉分数这类医疗AI工具时,最值得关注的一点。

图1 深脉分数分析界面及功能学评估结果示意
第一步:先准备一套“好教材”
算法训练首先离不开数据。对于基于冠脉CTA的医疗AI来说,影像数据就像模型学习时的“教材”。样本量固然重要,但数量不能替代数据质量与代表性;还要看数据来源是否合规、图像质量是否可控,以及标注或参考结果是否可靠。
不同患者的年龄、血管解剖和病变类型,以及不同中心、扫描设备、成像协议和图像质量,都可能影响数据分布。如果训练数据过于单一,模型可能很擅长处理“熟悉的病例”,但遇到新的临床场景时,表现就可能受到影响。因此,医疗AI训练首先要回答的不是:“有多少数据?”而是:“这些数据是否足够有代表性?”
第二步:给算法建立可靠的“参考标准”
有了数据,模型还需要知道自己到底应该学习什么。
这里要区分不同任务的“参考”:冠脉分割等结构提取任务通常依赖经过规范审核的解剖标注;功能学估算任务则需要与目标输出相匹配的参考结果。模型会从数据中学习影像与结构特征,并不等于人工预先规定它“应该关注哪些特征”。
这一步非常关键。因为模型最终能学到什么,很大程度上取决于训练数据本身以及参考标准是否稳定、可靠。换句话说,医疗AI训练并不是简单地“把很多影像交给电脑”,而是先把临床问题转化成机器能够学习的信息。
第三步:不断比较,让模型逐渐找到规律
真正进入训练阶段后,模型会不断比较:自己的预测结果,与参考结果之间有多大差异。如果差异较大,就调整内部参数;再看新的数据,再比较,再调整。经过多轮训练,模型逐渐学习影像特征与目标结果之间的关系。所以,算法训练的目的不是“记住某一个病例”,而是尽可能从大量数据中提取出能够应用到新病例中的稳定规律。
对于深脉分数而言,同样需要经历数据准备、模型训练、性能验证以及受控版本迭代等环节。真正决定其临床应用价值的,不只是算法本身,而是从数据到验证的完整开发链条。
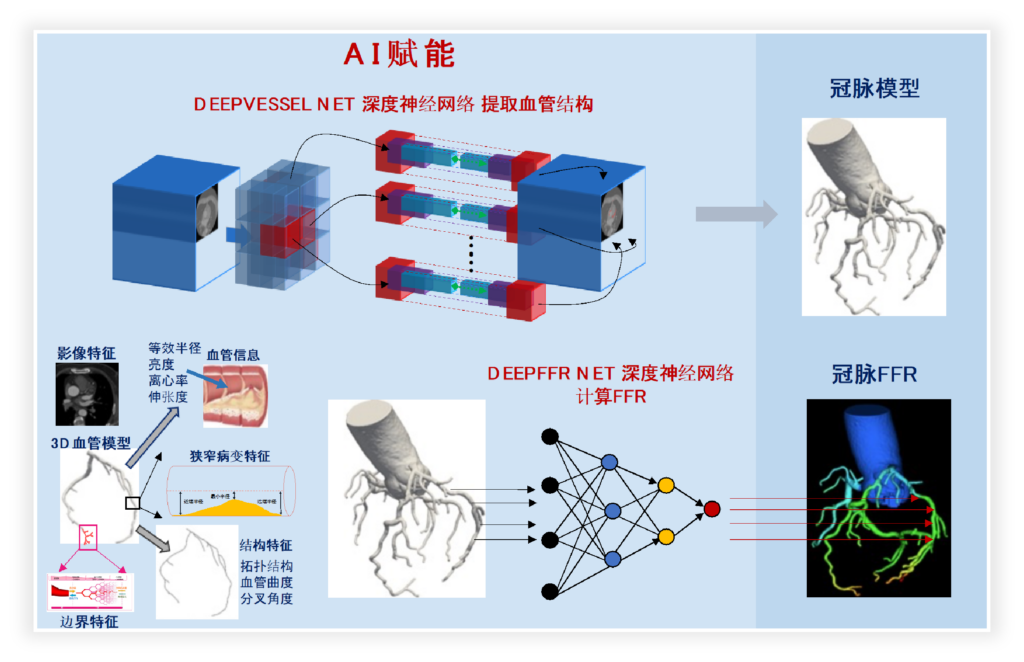
图2 深脉分数技术流程示意:基于冠脉CTA影像,通过深度学习完成冠脉结构提取与三维重建,并进一步进行功能学评估
第四步:真正的考试,是“没见过的病例”
模型在训练数据上表现很好,还远远不够,因为它可能只是“把题库背熟了”。开发阶段需使用与训练集、调优集不重叠的独立测试集评价性能;对医疗器械而言,还需要结合预期用途开展临床评价,以确认产品在预期使用条件下的安全性和有效性。独立测试的目的就是看:面对真正没见过的新病例,模型还能不能保持稳定表现?这一步尤其重要。若能在不同中心、设备或人群的数据上进行外部验证,更有助于判断模型在新场景中的泛化能力。对于医疗AI而言,这种泛化能力,往往比单纯在训练数据上取得漂亮结果更重要。
第五步:医疗AI并不是“越用越准”
这是最容易产生误解的一点。对于采用锁定模型的医疗AI,部署到临床后并不会因为今天分析了100例患者,明天就自动修改自己、变得更加准确。真正的模型优化通常需要经历:新数据积累 → 数据审核与标注 → 模型再训练 → 独立验证 → 受控版本更新。
也就是说,“算法越用越准”不如更准确地说,在更多高质量数据和严格验证的基础上,通过持续、受控的版本迭代,模型性能才有机会进一步优化。
每一次模型更新,都不只是“学得更多”,更重要的是:更新后的版本,还需要重新接受验证。
医生如何判断一个医疗AI是否值得信任?
答案并不是简单地看“它用了多少数据”或者“算法有多复杂”。更应该关注:
所以,对医疗AI而言,训练决定模型“学会了什么”,验证则回答它“能否稳定应用”。这也是评价深脉分数这类医疗AI工具时,比“网络有多深”“参数有多少”更值得关注的问题。

图3 深脉分数功能学评估结果示意。完成模型训练和验证后,算法可基于冠脉CTA提供冠脉沿程功能学评估结果,为临床判断提供参考。
结语
医疗AI的能力,并不是凭空产生的。它背后是一条并不神秘、但必须严谨的路径:高质量数据→ 明确任务与参考标准 → 模型训练与调优 → 独立测试 → 临床评价及软件验证与确认 → 受控迭代与上市后监测。真正值得信任的,也不是一个会在临床中随意“自我进化”的黑盒,而是一套版本受控、证据经过验证并纳入全生命周期质量管理的医疗工具。
评价一个医疗AI是否值得信任,关键不只是看它有多“聪明”,更要看数据是否覆盖目标人群和使用场景、参考标准是否可靠、数据划分是否独立,以及临床验证、适用条件和风险控制是否清楚。


